1. Open Catalyst Project介绍
Open Catalyst Project 是 Meta 公司的基础人工智能研究(FAIR)团队与卡内基梅隆大学(CMU)化学工程系之间的一项合作研究项目。其目标是利用人工智能对用于可再生能源存储的新型催化剂进行建模和发现,以助力应对气候变化。
为了让更广泛的研究群体能够参与到这个重要项目中,项目发布了用于训练机器学习模型的 Open Catalyst 2020(OC20)和 2022(OC22)数据集。这些数据集总共包含 134 万+个分子弛豫数据,其结果来自超过 2.6 亿次的密度泛函理论(DFT)计算。
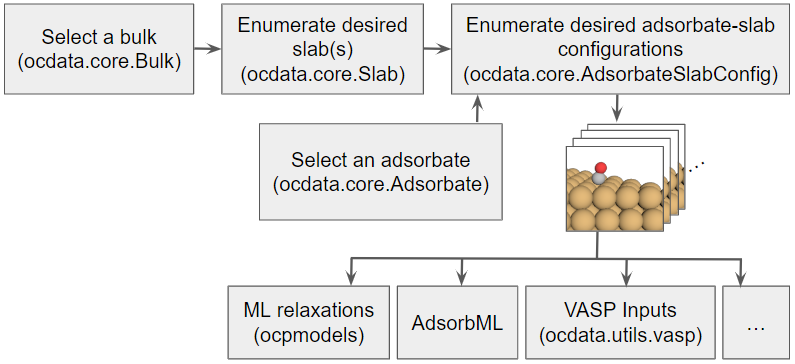
图1:在Open Catalyst Project中使用的吸附质 - 催化剂输入生成工作流程。
DFT relaxation计算的具体含义和目的
计算含义:DFT弛豫计算是从给定初始原子配置出发,通过迭代优化原子位置来寻找体系局部能量极小值构型的过程。这是理论催化研究的核心计算步骤。
主要目的:
- 结构优化:获得热力学稳定的吸附几何构型
- 能量确定:计算准确的吸附能和反应能垒
- 力平衡:确保原子间力达到设定收敛标准(0.05 eV/Å)
- 电子结构优化:获得自洽的电子密度分布
单点计算(single-point calculations)的定义
技术定义:单点计算是在固定原子几何构型下,仅计算电子结构和总能量而不优化原子位置的DFT计算。
在workflow中的关键作用:
- 轨迹记录:记录弛豫过程中每一步的能量和原子受力
- 训练数据生成:为机器学习模型提供结构-能量-力的精确对应关系
- 收敛监控:跟踪电子自洽场收敛过程
- 性质计算:计算电子密度、态密度等电子结构性质
三个主要任务S2EF、IS2RS、IS2RE的具体含义和目标
S2EF (Structure to Energy and Forces) - 结构到能量和力预测
技术含义:从原子结构直接预测系统总能量和每个原子的受力,是构建机器学习原子间势的核心任务。
输入输出格式:
- 输入:原子坐标、元素类型、晶胞参数
- 输出:系统总能量(eV)+ 每个原子的三维力向量(eV/Å)
应用价值:
- 加速分子动力学模拟(比传统DFT快4-5个数量级)
- 实时预测催化反应过程中的能量变化
- 为结构优化算法提供梯度信息
IS2RE (Initial Structure to Relaxed Energy) - 初始结构到弛豫能量预测
技术含义:直接从初始吸附构型预测结构弛豫后的最终能量,跳过昂贵的结构优化过程。
输入输出格式:
- 输入:初始吸附质-催化剂体系的原子坐标
- 输出:弛豫后系统的总能量(eV)
应用价值:
- 高通量筛选:无需完整结构优化即可评估吸附能
- 催化剂发现:快速评估材料的催化活性趋势
- 反应能预测:直接计算反应中间体的稳定性
IS2RS (Initial Structure to Relaxed Structure) - 初始结构到弛豫结构预测
技术含义:预测初始吸附构型经过完整结构优化后的最终原子坐标,是最具挑战性的结构预测任务。
输入输出格式:
- 输入:初始吸附质-催化剂体系的原子坐标
- 输出:弛豫后的完整原子坐标
应用价值:
- 结合位点预测:确定吸附质在催化剂表面的最稳定构型
- 反应机理研究:预测催化反应中间体的几何结构
- 表面科学:理解吸附质与表面的相互作用模式
2. OC20 Dataset
Open Catalyst 2020(OC20)数据集是迄今为止最大规模的电催化剂DFT计算数据集,由Meta AI(Facebook AI Research)和卡内基梅隆大学联合发布。该数据集为加速可再生能源催化剂发现提供了前所未有的训练资源,包含超过2.6亿次DFT单点计算,是催化材料机器学习研究的重要里程碑。
材料数据库来源和选择标准
OC20从Materials Project(MP)数据库中系统性选择bulks材料,采用严格的筛选标准:
- 元素数量限制:仅考虑最多含有3个元素的化合物,确保计算可行性
- 热力学稳定性:选择在MP数据库中经过DFT验证的稳定或亚稳定结构
- 晶体学完整性:要求具有完整的晶体学信息和对称性数据
- 结构去重:应用算法排除晶体结构重复,确保材料多样性
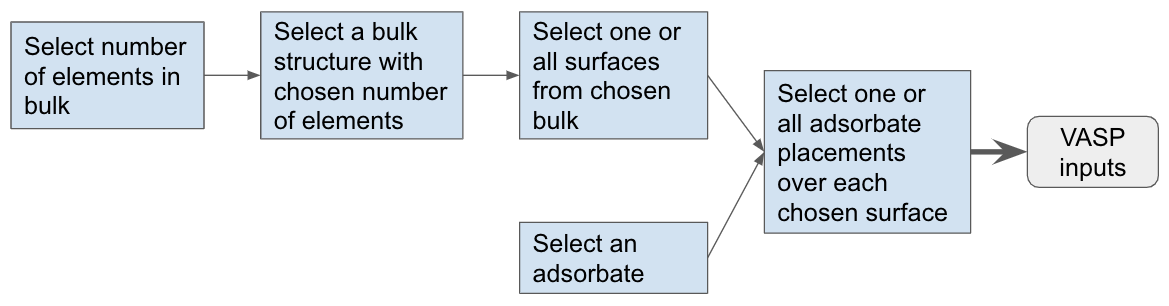
图2:在OC20中使用的吸附质 - 催化剂输入生成工作流程。
根据图2的工作流程,有:
- Bulks材料总数:约15,000个独特的晶体结构
- 催化剂表面:考虑最多125种不同Miller指数表面切面
- 吸附质种类:82种不同的吸附分子
- 初始结构采样:约250万个吸附质-催化剂初始配置(去重前)
总的relaxation数量和单点计算数量
准确数据统计:
- 完整弛豫计算:1,281,040次独立的几何优化任务
- 单点计算总数:约2.6亿次DFT评估
- 平均单点数:每个弛豫轨迹包含约200个单点计算步骤
- 总计算时间:超过200万核小时的DFT计算资源
训练集、验证集、测试集的分割方法和数量
S2EF任务数据分割
- 训练集分层设计:200k ⊂ 2M ⊂ 20M ⊂ 134M(全集)
- 200,000个结构(快速原型)
- 2,000,000个结构(中等规模训练)
- 20,000,000个结构(大规模训练)
- 134,000,000个结构(完整数据集)
- 验证/测试集:各约1,000,000个结构,分四个子集
IS2RS/IS2RE任务数据分割
- 训练集分层设计:10k ⊂ 100k ⊂ 460k(全集)
- 10,000个初始结构(快速测试)
- 100,000个初始结构(中等训练)
- 460,000个初始结构(完整训练集)
- 验证/测试集:各约25,000个结构,分四个子集
In-Domain、OOD Adsorbate、OOD Catalyst、OOD Both等子集的含义和数量
数据集按照泛化能力评估维度划分为四个测试子集:
In-Domain (ID) - 域内测试
- 含义:与训练数据分布相同的测试样本,包含训练集中见过的催化剂和吸附质组合
- 测试目的:评估模型在相似数据分布上的基础性能表现
- 基线性能:所有模型在ID测试集上表现最佳
OOD Adsorbate (OOD-Ads) - 域外吸附质测试
- 含义:包含训练中完全未见过的新吸附质分子的测试样本
- 挑战性:评估模型对新分子类型的化学泛化能力
- 测试难度:中等,模型需要外推到新的分子化学环境
OOD Catalyst (OOD-Cat) - 域外催化剂测试
- 含义:包含训练中未见过的新催化剂材料成分的测试样本
- 挑战性:评估模型对新材料体系的预测能力
- 测试难度:较高,需要模型理解新的电子结构和表面性质
OOD Both (OOD-Both) - 双重域外测试
- 含义:同时包含新吸附质和新催化剂材料的测试样本
- 挑战性:最严格的泛化性测试,评估完全未知化学体系的预测能力
- 测试难度:最高,要求模型具备强大的化学知识泛化能力
关键性能观察:
- 域内性能最佳:ID测试集上所有模型表现最好
- 催化剂泛化更困难:OOD-Cat比OOD-Ads更具挑战性
- 双重域外最困难:OOD-Both测试集性能显著下降
- 实用性差距:IS2RE任务的EwT指标仅2-6%,远低于实际应用需求
评估指标体系:
- S2EF任务:能量MAE、力MAE、EFwT(能量和力阈值内百分比)
- IS2RE任务:能量MAE、EwT(能量阈值内百分比,ε=0.02 eV)
- IS2RS任务:ADwT(平均距离阈值内百分比)、AFbT(平均力阈值内百分比)
OC20数据集的构建方法代表了计算催化领域数据集设计的重要进展。其系统化的数据生成流程、多维度的域外泛化评估策略和严格的质量控制机制,为机器学习模型在催化剂发现中的泛化能力评估提供了标准化平台。特别值得注意的是,该数据集通过完整轨迹保留、四重分割验证和唯一标识符系统,在保证数据质量的同时实现了对模型不同泛化维度的全面评估,为推动计算催化机器学习研究奠定了坚实基础。
3. OC22 Dataset
OC22数据集是为了解决氧化物电催化剂机器学习模型训练数据不足的问题而开发的。氧化物材料在氧气析出反应(OER)催化剂中至关重要,但由于其复杂性,相关的大规模数据集一直缺乏。
材料数据库来源和选择标准
OC22从Materials Project(MP)数据库中选择了51个元素,包括:
- 过渡金属:29个(到5d族,除Tc外)
- 碱金属和碱土金属:10个(到Fr)
- 镧系元素:2个(Ce和Lu)
- p区金属和类金属:11个(除Te外,到Po)
得到的材料数量:
- 原始候选材料:4,728个一元(AxOy)和二元(AxByOz)金属氧化物
- 实际采样材料:4,286个块体氧化物
- 筛选标准:
- 每个化学体系选择能量最低的前5个结构
- 原子数少于150个
- 部分材料的hull以上能量可能超过0.1 eV/atom
总的relaxation数量和单点计算数量
计算规模:
- 总relaxation数量:62,331个DFT relaxation(与OC20不同,所有原子都允许relaxation)
- 单点计算数量:约9,854,504个单点计算
- 计算资源:使用超过2.4亿核时
系统组成:
- slab系统:19,142个
- adsorbate+slab系统:43,189个
训练集、验证集、测试集的分割方法和数量
分割策略基于催化剂组成
- In-Domain (ID):训练集中见过的材料组成
- Out-of-Domain (OOD):训练集中未见过的催化剂组成
具体分割比例
- 训练集:包含adsorbate+slab和slab系统的组合
- 验证集和测试集:大小相似,包含独占的材料组成
- 目标:模拟催化剂发现中需要预测未见材料性质的实际情况
S2EF任务数据分割
- 训练集:8,225,293个结构
- ID验证集:394,727个
- OOD验证集:450,669个
IS2RS/IS2RE任务数据分割
- 训练集:45,890个系统
- ID验证集:2,624个
- OOD验证集:2,780个
独特创新点
- 首个大规模氧化物数据集:填补了氧化物电催化剂机器学习的空白
- 总能量预测:比吸附能预测更通用,可计算多种性质(表面能、反应能等)
- 复杂表面化学:
- 包含氧空位缺陷
- 多种表面终止
- 不同覆盖度的吸附
- 跨数据集学习:
- 联合训练OC20+OC22
- 微调策略从OC20迁移到OC22
- 实现了显著的性能提升
- 实验验证:与文献中的吸附能和标度关系对比,验证了模型的实用性
这个数据集为氧化物电催化剂的机器学习研究提供了重要的基础设施,特别是对于OER等重要电化学反应的研究具有重要意义。
4. 提供的附件说明
OC20 是由较旧版本的bulks数据(bulk_db_nelems_2020may12.pkl)以及较旧版本的吸附质数据(adsorbate_db_2020may12.pkl)生成的。由于该版本中bulks数据有 50 个重复的bulk条目,在最新版本(bulk_db_nelems_2021sep20.pkl)中已被移除,吸附质数据存在一个不一致性问题,在最新版本(adsorbate_db_2021apr28.pkl)中已得到修复。
OC22的bulks数据:bulk_oxides_20220621.json。
关于更多的数据库和工作流程代码说明参考https://github.com/Open-Catalyst-Project/Open-Catalyst-Dataset,https://github.com/facebookresearch/fairchem。
参考文献:
[1] Chanussot L, Das A, Goyal S, et al. Open catalyst 2020 (OC20) dataset and community challenges[J]. Acs Catalysis, 2021, 11(10): 6059-6072.
[2] Tran R, Lan J, Shuaibi M, et al. The Open Catalyst 2022 (OC22) dataset and challenges for oxide electrocatalysts[J]. ACS Catalysis, 2023, 13(5): 3066-3084.