利用强化学习方法从自由落体运动数据中自动发现物理规律,实现运动方程的符号化表达。
本任务支持科学智算工作流
点击下方按钮进入在线智算工作流环境
标签: 强化学习;符号回归;Deep Symbolic Regression
自由落体过程是经典动力学中的基础问题,但在真实实验条件下,多个形状不规则、受空气阻力与姿态扰动影响的小球,其下落轨迹往往不再满足理想匀加速模型,而会呈现出更复杂的非线性演化规律。对于此类问题,若仅采用传统黑箱回归模型进行拟合,虽然能够获得一定的预测精度,但难以进一步揭示变量之间的显式关系与潜在物理结构。相比之下,符号回归旨在直接从数据中发现可解析、可解释的数学表达式,更适合用于复杂动力学系统中的规律挖掘与机理建模。本工作流采用深度符号回归(Deep Symbolic Regression, DSR)模型,将表达式搜索过程建模为强化学习策略优化问题,从而在候选符号表达式空间中自动发现能够描述不规则小球自由落体轨迹的显式解析形式。
设实验观测得到的目标量为小球在时刻 的高度或位移,则其基本建模形式可写为
其中, 表示轨迹观测量, 为待识别的解析表达式。当进一步考虑不同小球之间的形状差异、初始状态差异或其他可观测因素时,可将问题扩展为条件符号建模形式
其中, 表示样本相关的条件变量,例如初始高度、尺寸特征、质量参数、阻力相关量或其他实验描述信息。给定观测数据集
其中, 表示输入变量, 表示对应的轨迹观测值,符号回归的目标是在预定义算子集合所张成的表达式空间 中寻找最优显式表达式 ,使得
其中, 由基本算子、变量节点与常数节点共同构成,通常包括加、减、乘、除、幂函数、指数函数、对数函数及其他任务相关的数学算子。该优化目标要求模型在保证拟合误差较小的同时,尽可能输出结构简洁、语义清晰且具有物理解释潜力的表达式。
在DSR框架中,候选表达式并非通过穷举搜索获得,而是由一个参数化策略网络逐步生成。该网络按照一定顺序依次输出运算符、变量和常数符号,并构造对应的表达式树或前缀序列表达。设一次采样得到的候选表达式记为 ,则可根据其在训练数据上的拟合表现定义奖励函数
其中, 表示表达式预测结果与真实观测之间的均方误差, 表示表达式复杂度项,用于衡量表达式长度、结构冗余或算子复杂程度, 为复杂度惩罚系数。通过该奖励设计,模型不仅会倾向于搜索拟合效果更好的表达式,也会偏向于保留更为紧凑和更具可解释性的结构。
基于上述奖励定义,DSR的强化学习优化目标可表示为
其中, 表示参数为 的策略网络所定义的表达式生成分布。其对应的策略梯度形式为
其中, 为基线项,用于降低梯度估计方差并提升训练稳定性。随着训练过程不断推进,策略网络会逐步提高高奖励表达式被采样到的概率,从而在符号空间中形成面向目标轨迹建模的有效搜索偏好。
在本工作流中,首先采集多个不规则小球的自由落体轨迹数据,并构造时间—位移或时间—高度形式的监督样本;随后由DSR模型在预定义符号库中自动生成大量候选表达式,并根据其预测误差与表达式复杂度计算奖励;最后通过强化学习更新策略网络参数,使其逐步聚焦于更优的表达式区域。该过程本质上是在离散符号空间中进行结构化搜索,既关注数值拟合能力,也强调表达式的简洁性与可解释性,因此能够将单纯的曲线预测问题进一步提升为可解释的规律发现问题。
与传统数值拟合方法相比,基于强化学习的符号化建模具有两个显著优势。其一,模型输出为显式数学表达式,便于后续进行物理分析、变量解释与规律归纳,而不仅仅是给出预测值;其二,符号表达式具有较强的可迁移性与可复用性,在面对相似实验设置或相关动力学场景时,能够作为后续建模的重要先验。这使得DSR不仅适用于不规则小球落地轨迹的预测任务,也适用于更一般的复杂动力学过程符号发现与机理建模任务。
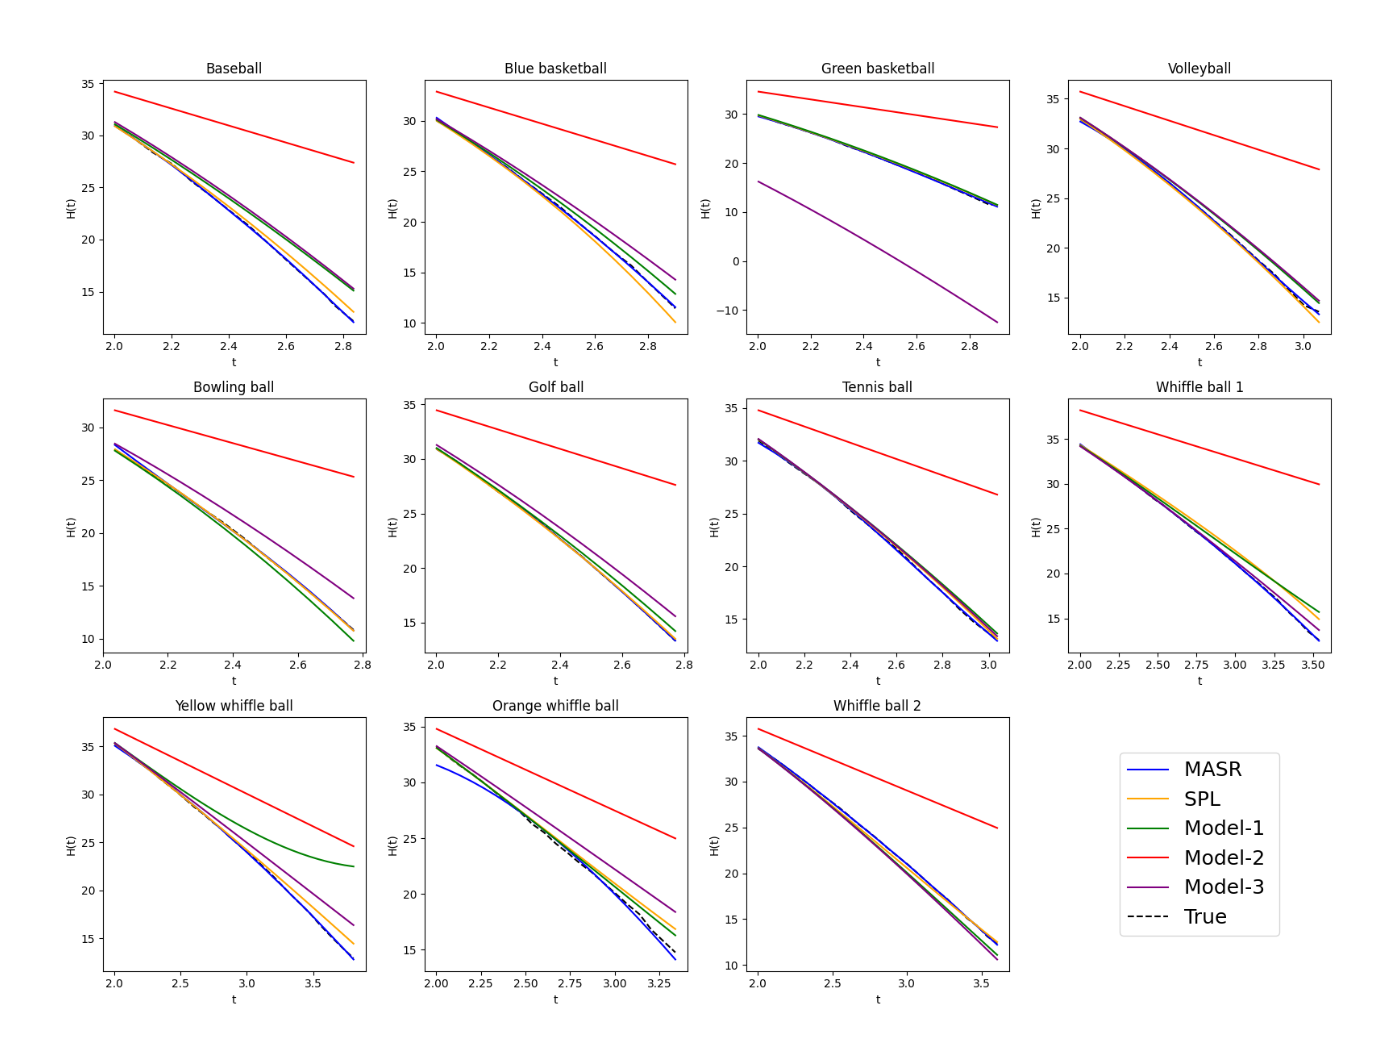
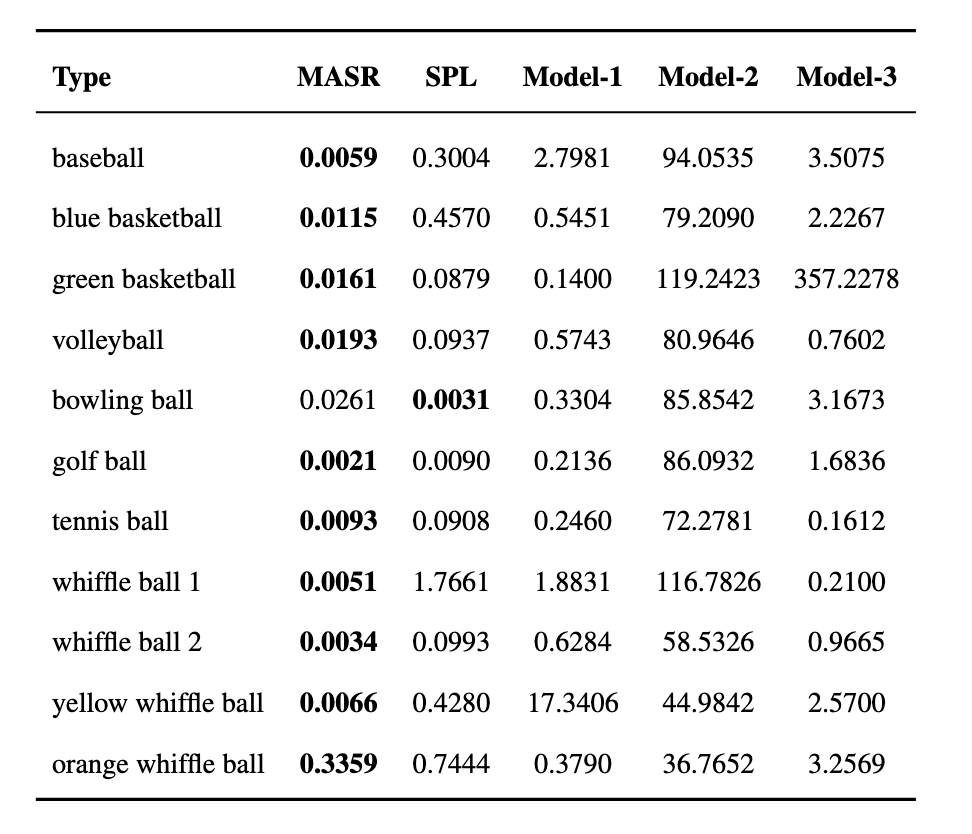
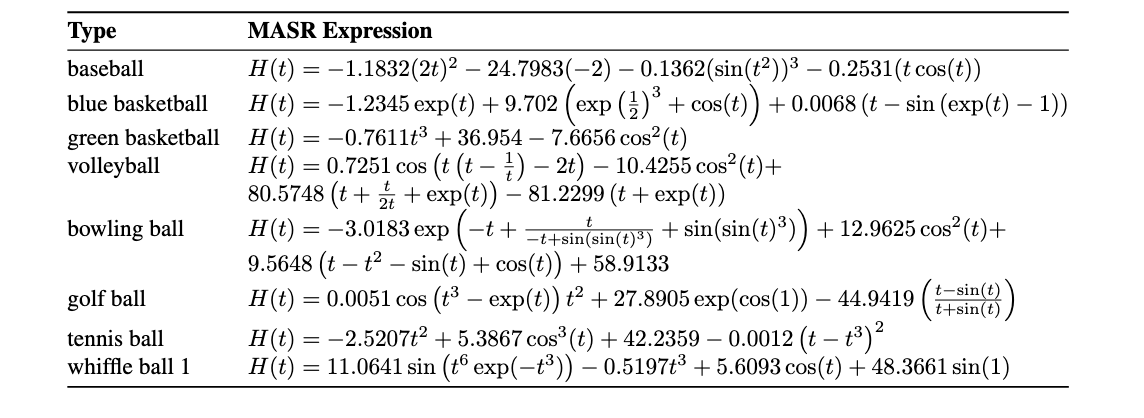
图1展示了DSR模型对多个不规则小球自由落体轨迹的符号化拟合结果与真实观测曲线之间的对比。结果表明,该方法能够在保持较高预测精度的同时,自动发现具有较强解释性的轨迹表达式,从而实现从数据拟合到规律表达的统一建模。
 自由落体符号回归过程1
 自由落体符号回归过程2
 自由落体符号回归过程3
学科领域
数学
贡献方
北航
方法
AI/ML
问题类型
方程求解